从零手写大模型 · 推理篇 05 - Self-Attention(自注意力机制)
推理篇 · 查看系列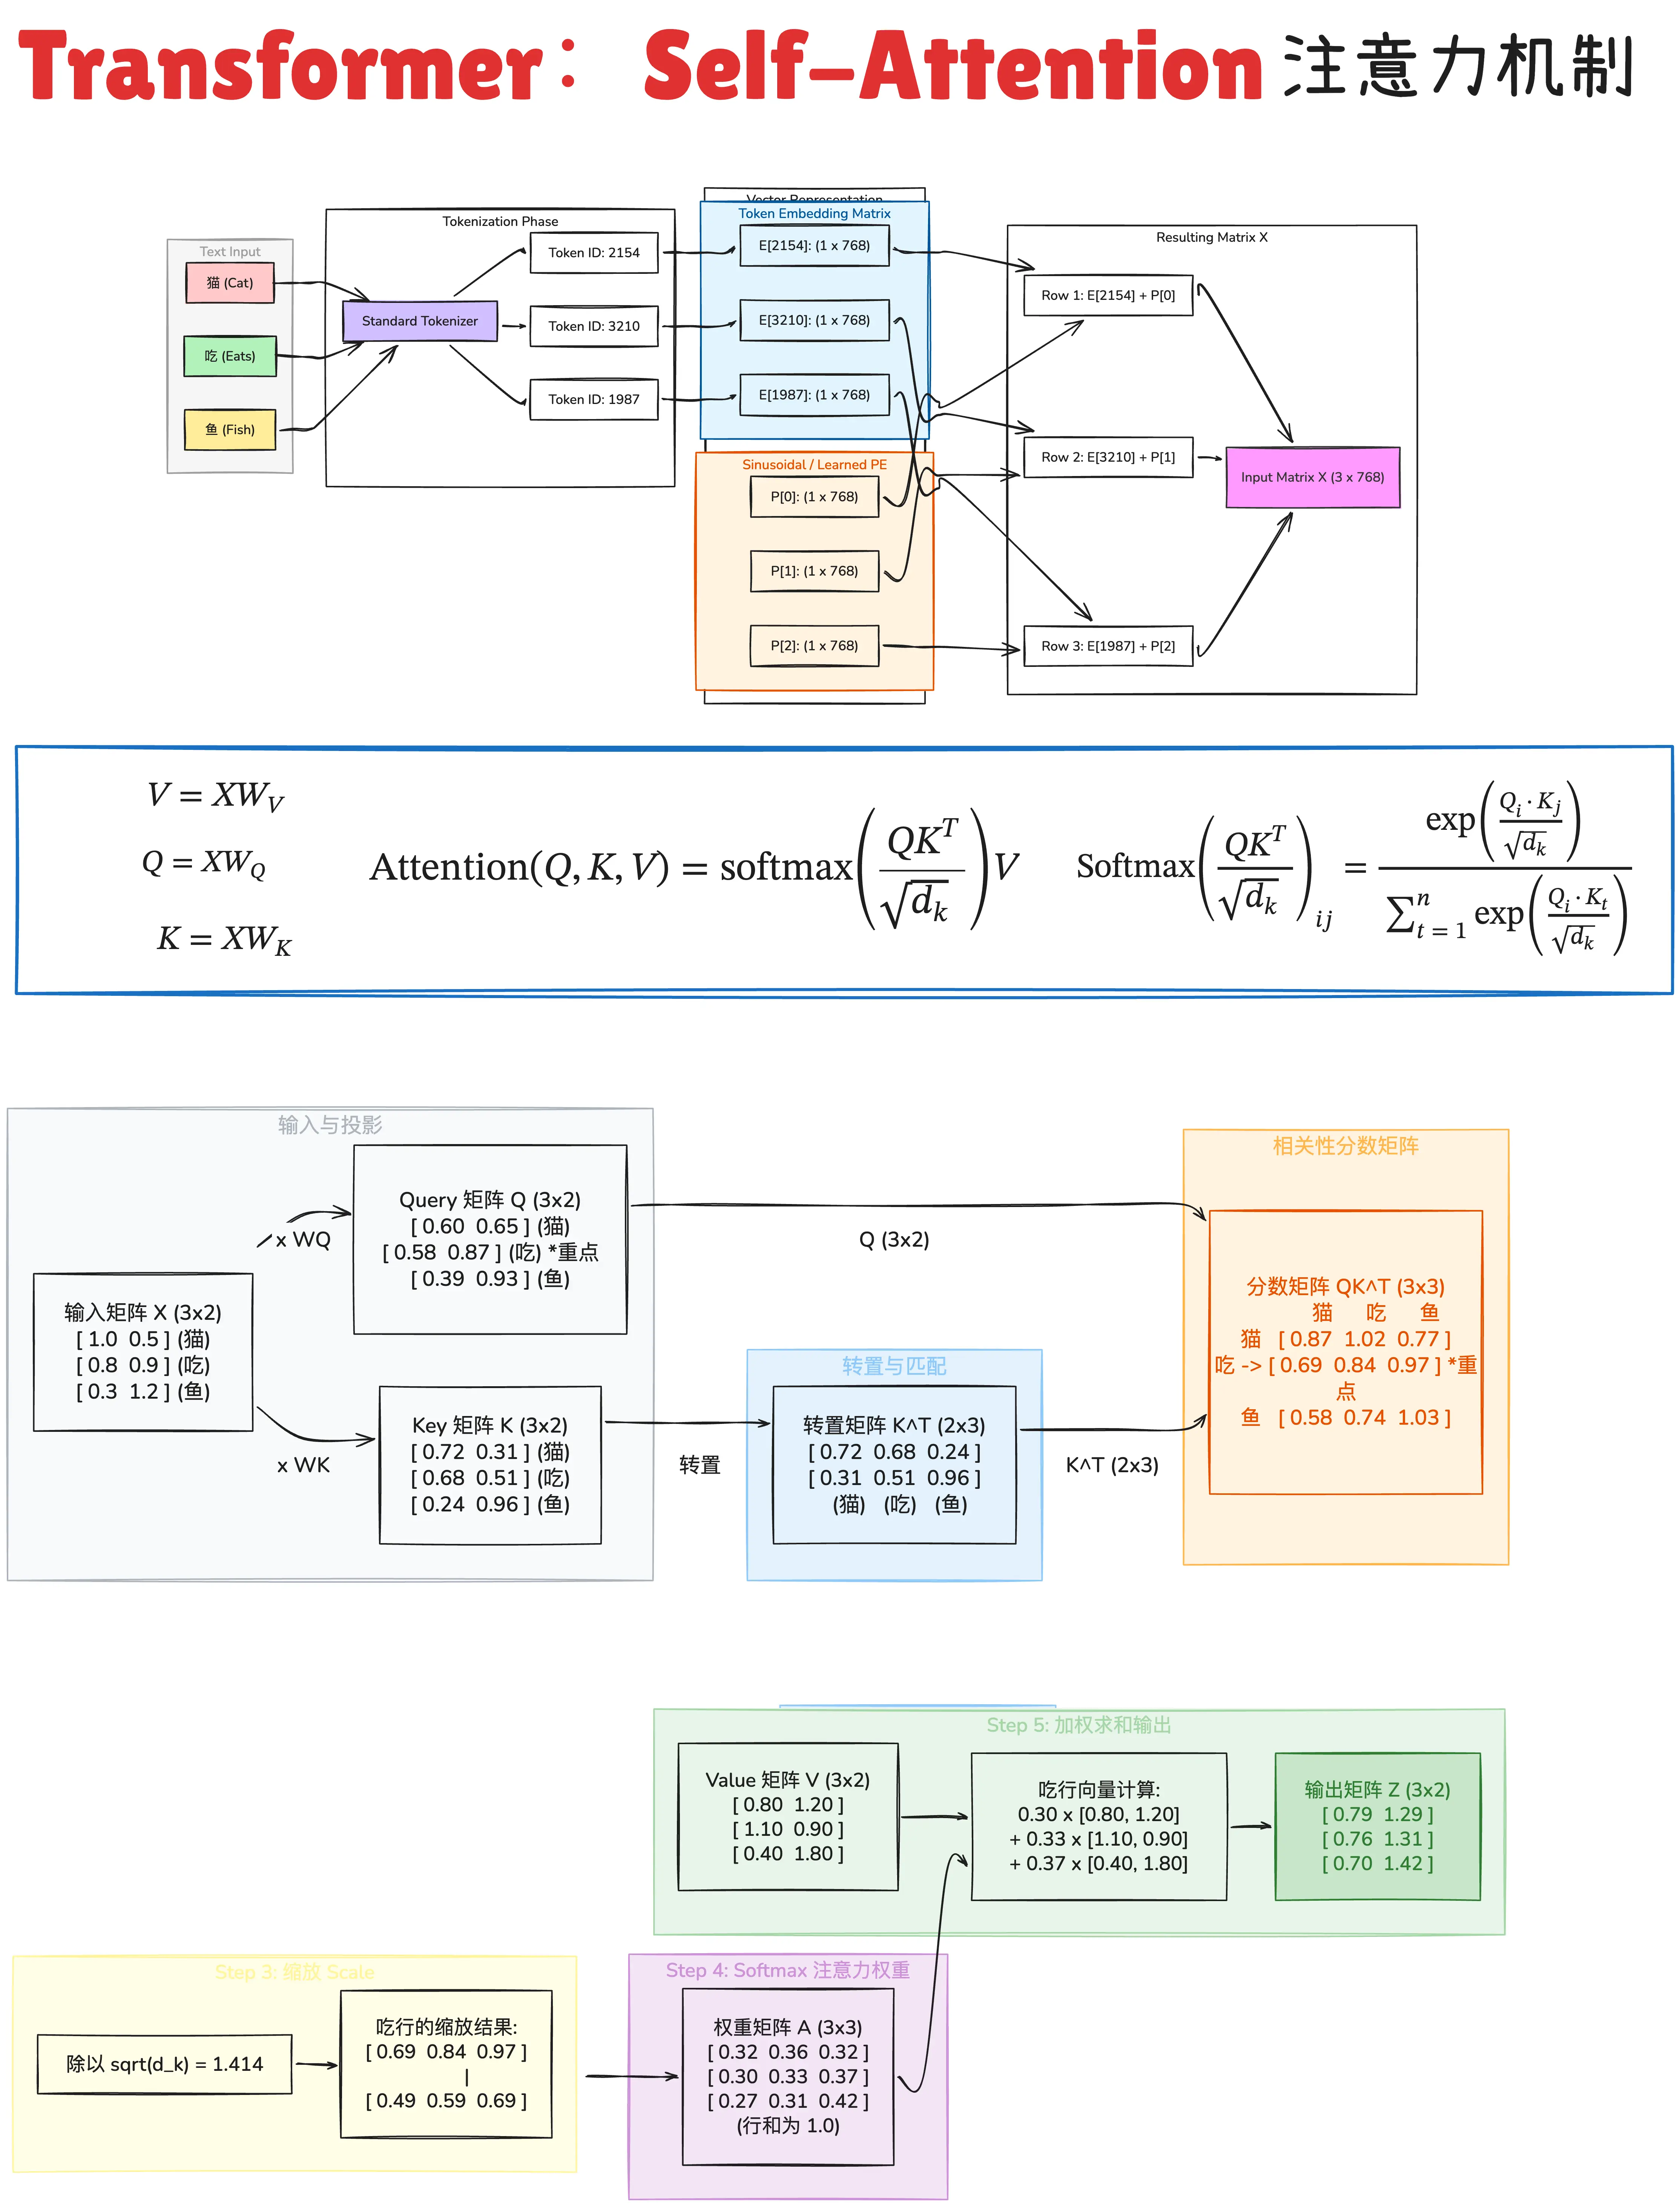
系列回顾:EP01 项目路线 → EP02 Tokenizer → EP03 Embedding(词变成了向量)→ EP04 Positional Encoding(向量有了顺序)→ 本期 EP05,向量之间终于要开始"说话"了。
一、上期埋的坑,这期来填
EP04 结尾我们解决了一个问题:Embedding 只知道"这个词是什么",不知道"这个词在哪"。加上位置编码之后,"猫吃鱼"和"鱼吃猫"终于不再是两个一模一样的向量序列了。
但这只解决了位置问题,没解决关系问题。
还是这句话:猫吃鱼。
对于"吃"这个字,模型在处理它的时候,应该更关注"猫",还是更关注"鱼"?
人一眼就能看出来:"吃"这个动作,主语是"猫",宾语是"鱼",两个都很重要,但重要的方式不一样——一个是"谁在吃",一个是"吃的是什么"。
Embedding + Positional Encoding 给了模型三个互相独立的向量,它们之间还没有产生任何"关联"。让词与词之间开始互相"看一眼"、互相"打分"、互相"取长补短",就是**自注意力机制(Self-Attention)**要干的事。
📌 这也是 Transformer 论文标题里那个词的由来——《Attention Is All You Need》,整个模型架构的核心机制,就是这一期的主角。
二、后端人的理解方式:Self-Attention 就是一次 JOIN 查询
如果你写过 SQL,理解 Self-Attention 会快很多。
假设你要查"猫吃鱼"这句话里,"吃"这个词应该关注谁。这个过程可以类比成一次模糊匹配的 JOIN:
| Transformer 概念 | SQL 类比 | 含义 |
|---|---|---|
| Query(Q) | 你的查询条件 | "我(吃)想找和我相关的词" |
| Key(K) | 每一行数据的索引字段 | 每个词拿出来"被检索"的那部分特征 |
| Value(V) | 索引对应的实际数据 | 每个词真正携带的信息内容 |
普通的 SQL JOIN 是精确匹配(WHERE a.id = b.id),命中就是命中,不命中就是 0。
但 Self-Attention 做的是模糊匹配:Query 和每一个 Key 都会算出一个"相似度分数",这个分数不是 0 或 1,而是一个连续值——「吃」和「猫」的匹配度可能是 0.6,和「鱼」的匹配度可能是 0.35,和自己的匹配度是 0.05。
拿到这些分数之后,不是"取分数最高的那一行",而是按分数比例,把所有 Value 加权混合在一起——这是和 SQL JOIN 最大的不同:SQL 是二选一,Self-Attention 是"每个都要一点,但权重不同"。
三、Q、K、V 从哪来:三个可学习的矩阵
一个很关键、初学者容易搞混的点:
Q、K、V 不是三种不同的输入,它们都来自同一个词向量,只是被三个不同的权重矩阵分别投影了一次。
对于"猫吃鱼"里的每一个词向量 (经过 Embedding + Positional Encoding 后,维度是 d_model=8),会分别乘上三个可学习的权重矩阵:
- :输入矩阵,形状
(3, 8)—— 3 个词,每个词 8 维 - :三个独立的权重矩阵,形状都是
(8, 8)(本期先不拆多头,所以维度不变) - 得到的 :形状同样是
(3, 8)
这三个矩阵一开始是随机初始化的,训练过程中会不断调整——模型是在训练中"学会"怎么提问(Q)、怎么被检索(K)、该交出什么信息(V),这三者不是人工设计的规则。
四、核心公式:缩放点积注意力
论文里给出的公式是这样的:
拆成四步,对照人话来看:
| 步骤 | 公式 | 人话解释 |
|---|---|---|
| ① 算相似度 | 每个词的 Query 分别和所有词的 Key 做点积,点积越大表示越"匹配" | |
| ② 缩放 | 维度越高,点积数值会越大,除以 把数值拉回合理区间,防止后面 Softmax 梯度消失 | |
| ③ 归一化 | 把一行分数变成加起来等于 1 的"权重",也就是"关注比例" | |
| ④ 加权求和 | 用这组权重,把所有词的 Value 按比例混合成一个新向量 |
Vaswani 等人在论文 3.2.1 节解释了缩放的原因:当 较大时,点积结果的数值会变大,把 Softmax 推向梯度极小的区域,因此需要除以 做缩放。
为什么除以 而不是别的数? 直觉理解: 和 的每一维如果是独立的随机变量,点积的方差会随维度线性增长,除以 正好把方差重新归一到 1 左右,Softmax 才不会因为输入值过大而变成"非 0 即 1"的极端分布。
五、跟着"猫吃鱼"手算一遍
为了方便手算,这里把维度简化成 d_k=4(实际代码里维度是 8,逻辑完全一样)。
假设经过投影后,三个词的 Query、Key 已经算出来了(简化后的示意数值):
       Query                Key
猫   [1.0, 0.2, 0.1, 0.0]  [0.9, 0.1, 0.0, 0.2]
吃   [0.3, 0.8, 0.2, 0.1]  [0.2, 0.7, 0.3, 0.0]
鱼   [0.1, 0.1, 0.9, 0.3]  [0.0, 0.2, 1.0, 0.1]
我们只看"吃"这一行的 Query,和三个 Key 分别做点积:
- 吃 · 猫的Key ≈ 0.3×0.9 + 0.8×0.1 + 0.2×0.0 + 0.1×0.2 = 0.37
- 吃 · 吃的Key ≈ 0.3×0.2 + 0.8×0.7 + 0.2×0.3 + 0.1×0.0 = 0.68
- 吃 · 鱼的Key ≈ 0.3×0.0 + 0.8×0.2 + 0.2×1.0 + 0.1×0.1 = 0.37
除以 ,再做 Softmax,大致会得到类似:
关注权重:猫 0.30 吃(自己)0.42 鱼 0.28
这组数字只是示意,真实值取决于训练后的权重矩阵。但它演示了核心结论:"吃"这个词,会用大约三成的关注力看"猫",三成看"鱼",剩下留给自己——而不是像人脑那样非黑即白地只认定一个主语。
六、代码实现(PyTorch,对应视频演示部分)
import torch
import torch.nn.functional as F

# 猫吃鱼,d_model = 8
# X: 经过 Embedding + Positional Encoding 之后的输入,形状 (3, 8)
X = torch.randn(3, 8)

d_model = 8
d_k = 8  # 单头注意力,先不拆分维度

W_q = torch.nn.Linear(d_model, d_k, bias=False)
W_k = torch.nn.Linear(d_model, d_k, bias=False)
W_v = torch.nn.Linear(d_model, d_k, bias=False)

Q = W_q(X)   # (3, 8)
K = W_k(X)   # (3, 8)
V = W_v(X)   # (3, 8)

# 第一步:算相似度
scores = Q @ K.T                      # (3, 3)

# 第二步:缩放
scores = scores / (d_k ** 0.5)

# 第三步:归一化成权重
attn_weights = F.softmax(scores, dim=-1)   # (3, 3),每一行加起来等于 1

# 第四步:加权求和
output = attn_weights @ V             # (3, 8)

print("注意力权重矩阵:\n", attn_weights)
print("输出:\n", output)
attn_weights 就是一个 3×3 的矩阵——这正是可视化环节要画的那张热力图:行代表"谁在看",列代表"看向谁",格子颜色深浅代表关注程度。
七、小结 & 下期预告
这一期我们把 Embedding 和 Positional Encoding 产出的"孤立向量",变成了"互相知道彼此存在"的向量:
- Self-Attention 不是精确匹配,而是加权融合——像一次模糊匹配的 JOIN 查询
- Q、K、V 都来自同一份输入,只是被三个可学习的矩阵投影了三次
- 缩放点积注意力公式的四步:相似度 → 缩放 → 归一化 → 加权求和
- 除以 是为了防止 Softmax 梯度消失,而不是随便定的常数
但这里有个问题:现在我们只用了一组 ,也就是说模型只能学会"一种"关注模式。可现实中,"吃"这个词,可能既要关注"谁在吃"(语法关系),又要关注"吃的对象是什么"(语义关系)——一个脑袋,装不下这么多种关注方式。
如果同时开好几个"脑袋",各自学一种关注模式,最后再把结果拼起来呢?
下一期,Multi-Head Attention。